第5章搭知识库时,检索方式那一栏随手选了"向量检索",检索设置里还闪过"混合检索""权重设置""Rerank模型"这几个选项,当时没细讲。这一章专门把这几个词讲透——不需要写代码、不需要背公式,只要建立正确的直觉,够学员理解"为什么要这样配"就行。
6.1 先搞清楚"召回"到底是什么
**召回(recall)**,就是用户一提问,先去知识库里把"可能相关"的内容捞出来的这个动作。它是LLM开口说话之前的"备菜"环节——LLM只能看到召回捞出来的这几条内容,捞得准不准、全不全,直接决定了它答得靠不靠谱。
- 系统跑完检索,"成功找回正确 chunk"的题数 ÷ 总题数 = 召回率。
例如,同一批人工标注问题里,命中正确 chunk 的题数除以总题数,就是召回率。具体数值由你的评估集和检索结果计算,不要沿用教程示例作为项目结果。
召回率是评估 RAG 检索好不好最重要的指标
6.2 两种基础召回方式,各有各的优劣
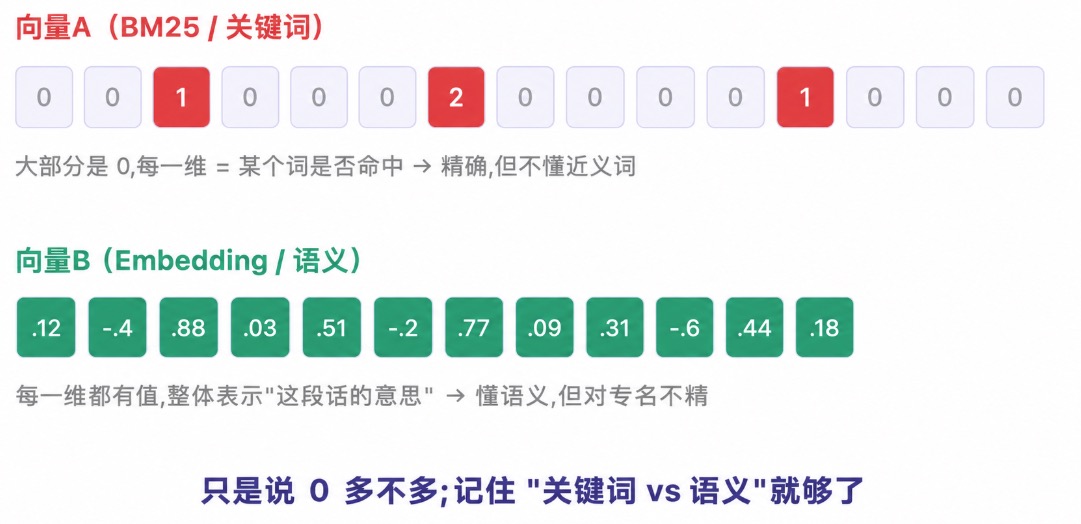
向量检索(语义检索)
回忆一下第5章讲过的类比:向量化就是把文字变成宇宙里的坐标点,检索就是找哪个点离用户问题最近。
强项:懂语义,换个说法也能找到
    用户问"瓜果",知识库写的是"水果",向量检索能懂这是一回事

弱项:对"精确的东西"不敏感
    真实踩坑案例:问"车厘子二斤装",向量检索可能返回"车厘子礼盒装"
    (相似度99%,但答案是错的)——型号、规格、编号这类需要
    "一字不差"匹配的内容,恰恰是向量检索的弱点
全文检索 / 关键词检索(BM25)
靠字面上"命中了哪些词"来打分,命中的词越稀有、越集中,分数越高。
强项:精确匹配准,型号/编号/数字这类内容它反而拿手

弱项:不懂语义,换个说法就找不到
    用户问"榴莲怎么看好坏",知识库写的是"闻着有没有酒精味",
    两句话没有共同关键词,关键词检索大概率会漏掉
BM25打分背后的三个直觉(不用背公式,知道逻辑就行):
1、稀有词更值钱:"的""是"这种词没用,"榴莲"这种词命中了才有价值
2、词频饱和:一个词出现10次不代表比出现5次相关度高2倍,涨幅是递减的
3、文档越长扣分越多:不能靠堆字数占便宜
一句话总结这两者的关系:向量检索懂"意思",关键词检索懂"字面",谁都不能完全替代谁。
6.3 为什么需要"混合检索"
既然两种方式各有死穴,且死穴刚好互补——那就都用上,取长补短。这就是混合检索:向量检索和关键词检索各自跑一遍,再想办法把两份结果合成一份最终排序。
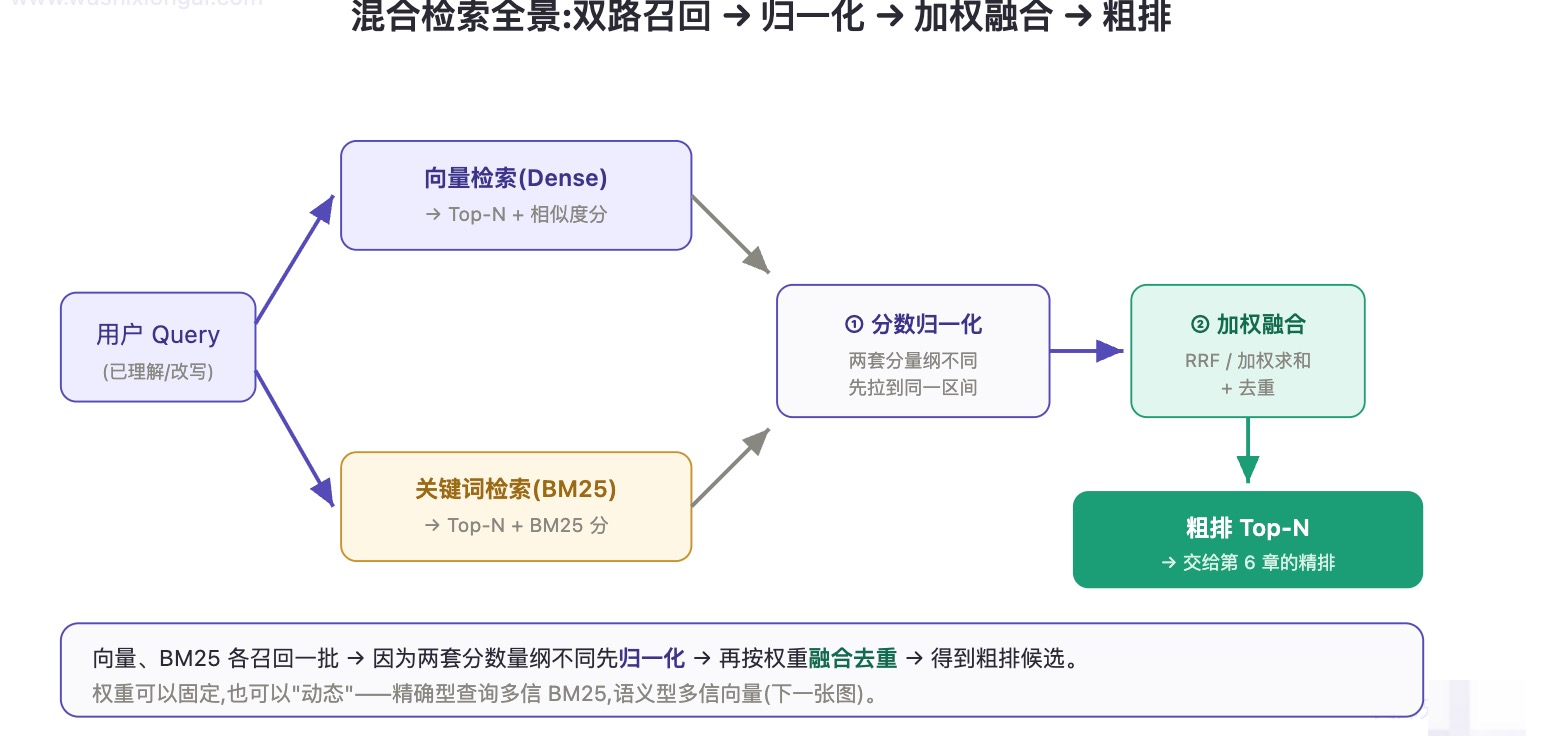 实测数据:从纯向量检索换成混合检索,**准确率提升了20%**。不过这个提升幅度不是固定的——数据量越大、越需要精确匹配(型号、编号这类内容),混合检索的优势越明显;数据量小、问题都比较笼统时,纯向量检索和混合检索差别不大,呼应第5章"先跑通再优化"的方法论:教学项目十几条数据,先用向量检索就够,不用一开始就上混合检索。
6.4 混合检索最烧脑的一步:两份不同"标准"的分数,怎么合成一份排序?
这是本章真正要讲透的核心,也正是这次真实报错(网易有道 reranker 403)发生的地方。
向量检索给的分数:相似度,0~1之间(比如0.87)
关键词检索给的分数:BM25分数,没有固定上限,跟词频、文档长度有关

这两种分数根本不是一回事,
不能直接放在一起比大小,简单相加也不严谨——
好比一个评委打百分制,另一个评委打五星制,
两份打分直接相加没有意义。
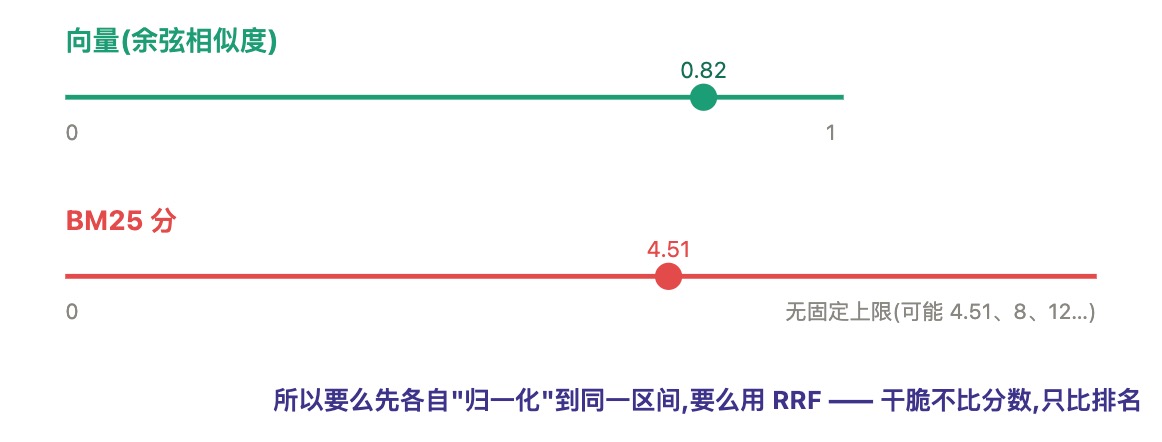 要合成一份排序,Dify界面上给了两条路,也就是你在「检索设置」里实际看到的两个互斥选项:
路径A:权重设置——"不比原始分数,比名次"
不去比较两份分数本身的大小,而是分别看每份结果里"排第几名",
给语义排名和关键词排名各自设一个权重(比如语义0.7/关键词0.3),
按加权后的名次重新排一次顺序。

好处:不需要额外调用任何模型,免费、快,
     没有外部依赖,不存在权限/额度报错的风险
代价:本质是个简化的估算,两种排名背后的判断逻辑不一样,
     强行按比例合并,不是最精确的做法
RRF(Reciprocal Rank Fusion排名倒数融合)-dify不涉及
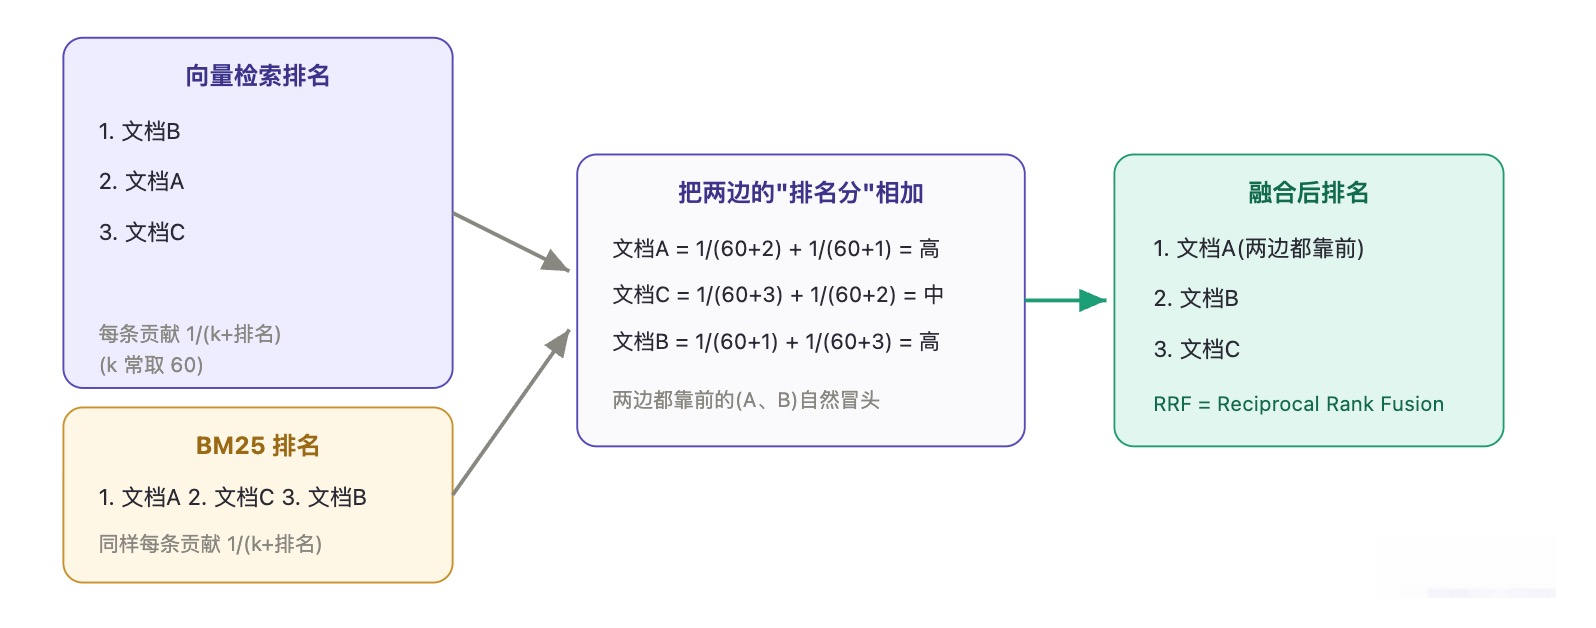 权重设置(加权分数融合)
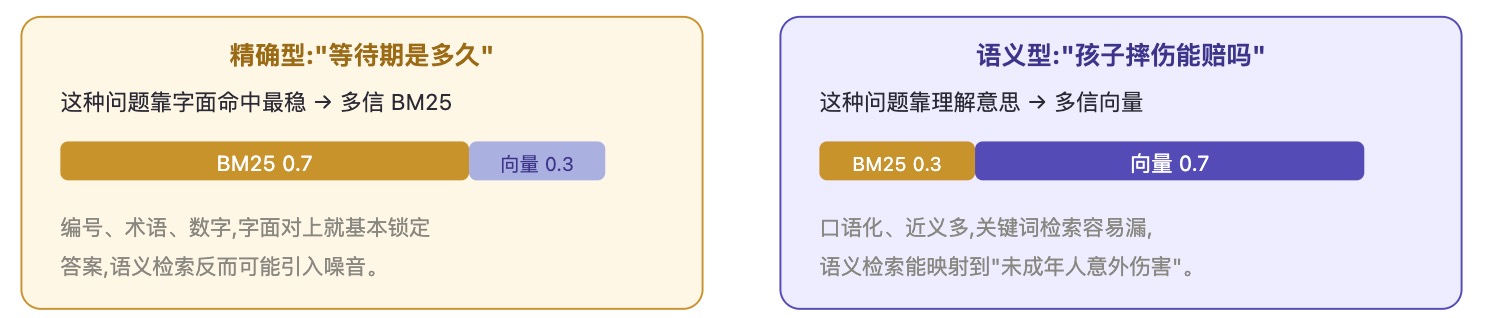
路径B:Rerank模型——"换一个统一标准的裁判,重新打一次分"
不去合并两份旧分数,而是把候选内容和用户问题重新一起交给
一个专门训练来"判断相关度"的模型,让它统一打一套全新的分数。

好处:通常比权重设置更准,尤其是候选内容彼此看着都很像、
     需要仔细比对才能分高下的时候
代价:多一次真实的模型调用——多花钱、多一点延迟、
     多一个可能失败的外部依赖
这正是你们这次真实踩到的坑: 检索设置里选了混合检索,默认选中的是"Rerank模型"这个选项,用的是网易有道的reranker,而这个模型对应的供应商权限没配置好,调用直接报403,导致这条分支的检索一直返回空——AI手里没有任何真实资料,又不肯说"不知道",就开始编答案了。这跟第2章开头"榴莲答成牛油果"的翻车故事、第10章记录的坑、附录C的幻觉解剖案例,本质上是同一类问题的不同表现。
解决方法: 切换到「权重设置」,把权重滑到语义1.0,就完全绕开了这次出问题的外部模型调用。
6.5 企业知识:真正的企业级系统,召回和精排通常是两个独立节点
你们现在用的Dify「知识检索」节点,把"召回(向量+关键词)"和"精排(Rerank模型)"打包成了一个节点里的两个选项——选哪个,整条流水线就走到哪一步为止,不用你自己拼节点。但真正的企业级系统,通常会把这两者拆成两个真正独立部署的服务,原因是它们对资源的需求完全不一样:
召回(向量检索/BM25):
    要扛得住高并发、低延迟,面对的是"全库"(可能几百万上千万条),
    通常由专门的向量数据库(Milvus、Pinecone、Elasticsearch这类)
    单独部署、单独扩容

精排(Rerank模型):
    是吃GPU算力的重活,但只处理"召回筛出来的一小撮候选",
    请求量比召回小得多,通常单独部署成一个推理服务,
    按自己的节奏扩容
一个内存/IO密集,一个算力密集,硬塞进同一个服务里,扩容的时候没法"只加精排的机器、不动召回的机器",企业级系统几乎都会把它们拆成两个独立部署的组件。
拆开还有一个好处,真正拆成两个独立节点/服务的架构,通常会做"降级"处理:精排服务挂了,系统可以选择跳过精排、直接用召回+粗排的结果兜底,而不是让整个检索直接失败变成空。这是企业级系统愿意多拆一个节点出来的实际收益——不仅是性能上的独立扩容,还多了一层"某个环节挂了,能不能优雅降级"的容错空间。拆开之后也更方便单独监控"召回命中率"和"精排耗时",出问题时一眼看出是哪一环拖后腿。
对回用的Dify: 把召回+精排打包成一个节点来配置,是低代码平台的设计取舍——图的是"搭建快、不用自己管基础设施.真正的企业级系统,会愿意多花工程成本,把这两层拆成独立部署的组件,换取扩容灵活性和故障隔离能力。
6.6 记忆点
两个评委,一个打百分制,一个打五星制,
直接把分数加在一起没有意义。

权重排名:RRF:要么"看名次"综合排位——这是权重设置在做的事
rerank:要么"换一个统一标准的裁判、重新打一次分"——这是Rerank模型在做的事
6.7 什么时候该选哪个
数据量小(教学项目,10-20条)
    → 用权重设置就够,没必要为不明显的提升,
      多背一个外部依赖失败的风险

数据量大、候选内容彼此很相似
(比如同一款商品的十几种规格、型号相近的零件)
    → Rerank模型的优势才会真正显现出来,值得多花这个成本,
      但要提前确认好对应供应商的权限/额度配置好了
6.8 召回之后还有两道阀门:Top K 和 Score阈值
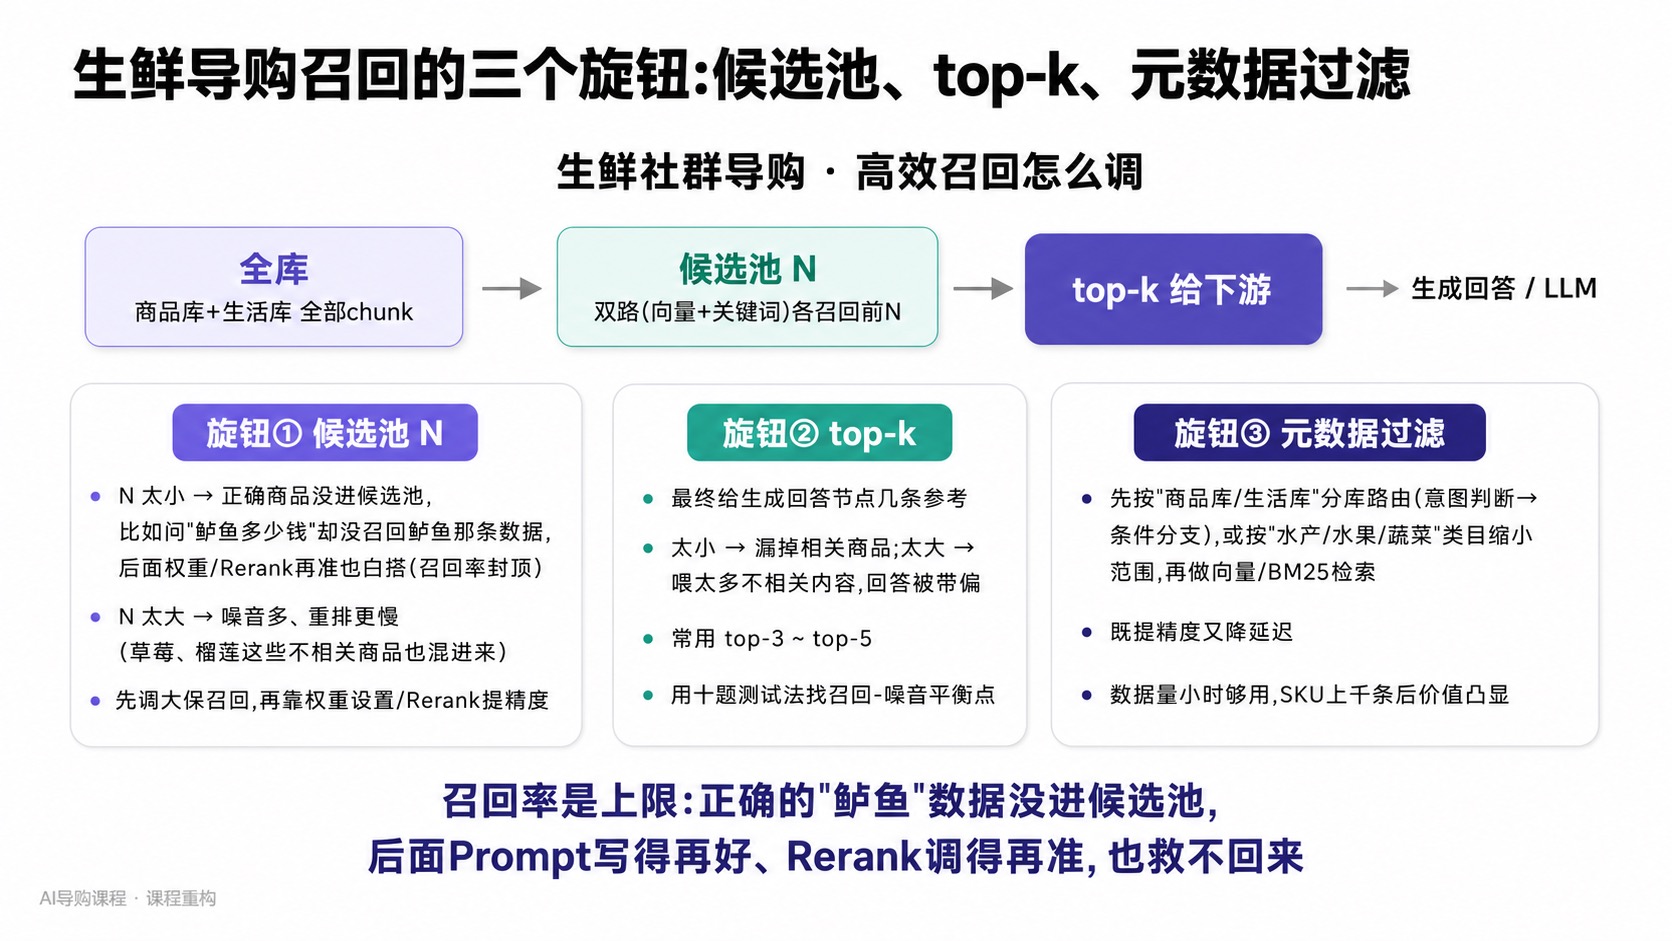
召回捞出来的候选,不会全部塞给LLM,中间还有两道阀门控制"到底给几条、给多相关的":
Top K = 3
    只取排名前3的候选给LLM参考,K越大给的越多,但也越容易夹带不相关内容

Score阈值(默认关闭)
    给相似度设一条及格线,低于这条线的候选,就算排进了Top K也不返回
为什么需要Score阈值——两个真实案例:
案例一:问"青苹果好不好吃",库里有"红苹果"(相似度72%)和
       "青苹果"(相似度100%)——红苹果要不要一起返回?
       这就是Score阈值要回答的问题:设个门槛(比如0.5),
       低于门槛的红苹果就不会被当成"相关内容"塞给LLM

案例二:"矬子里拔将军":知识库里压根没有真正相关的数据
       (比如问菌菇怎么保存,库里只有鲈鱼、榴莲的内容),
       但Top K设置是"强制"返回3条,检索还是会硬凑3条
       最不那么不相关的内容出来,LLM拿着这些牛头不对马嘴的
       资料,一样会答得驴唇不对马嘴
       → 开启Score阈值(比如0.45),能直接过滤掉这类"凑数"的内容
现在数据量小,先保持默认关闭;等真的发现检索返回了不相关内容拖累回答质量时,再回来打开这道阀门去过滤。
企业知识:具体权重多少,永远是测出来的,不是拍脑袋定的
本章小结: 检索召回决定LLM能看到什么;向量检索和关键词检索各有短板,混合检索是把两者结合;结合的方式有"权重设置"(比名次,零成本)和"Rerank模型"(重新统一打分,更准但多一个外部依赖)两条路——选哪条,看数据规模和你能不能承受额外的调用风险。这一章的原理,会在第10章的实际界面操作中再次用到。