之前搭的这套系统,是完整企业级系统里最核心的"骨架".这份文档帮你看清——骨架长什么样,骨架之外还要补哪些"肉"
一、先看实操中教的"主干"是什么样
用户输入

↓

【实操没加,企业级会加】Query重写(补全省略的主语/代词)

↓

意图判断/分类(决定这句话属于哪一类)

↓

条件分支(路由到对应处理逻辑)

↓ ↓ ↓

导购分支 知识分支 模糊分支

↓ ↓ ↓

知识检索(RAG核心:切片、向量化、召回、排序)

↓ ↓ ↓

生成回答(LLM结合检索内容组织语言)

↓ ↓ ↓

直接回复(输出给用户)
这条主干,覆盖了RAG系统最核心的闭环:意图理解→检索→生成→输出。这是企业级系统的"心脏",缺了这部分什么都不用谈。实操教的就是这一条主干,从零到能跑通、能测试、能迭代。
二、完整企业级系统,在这条主干之外还要加什么
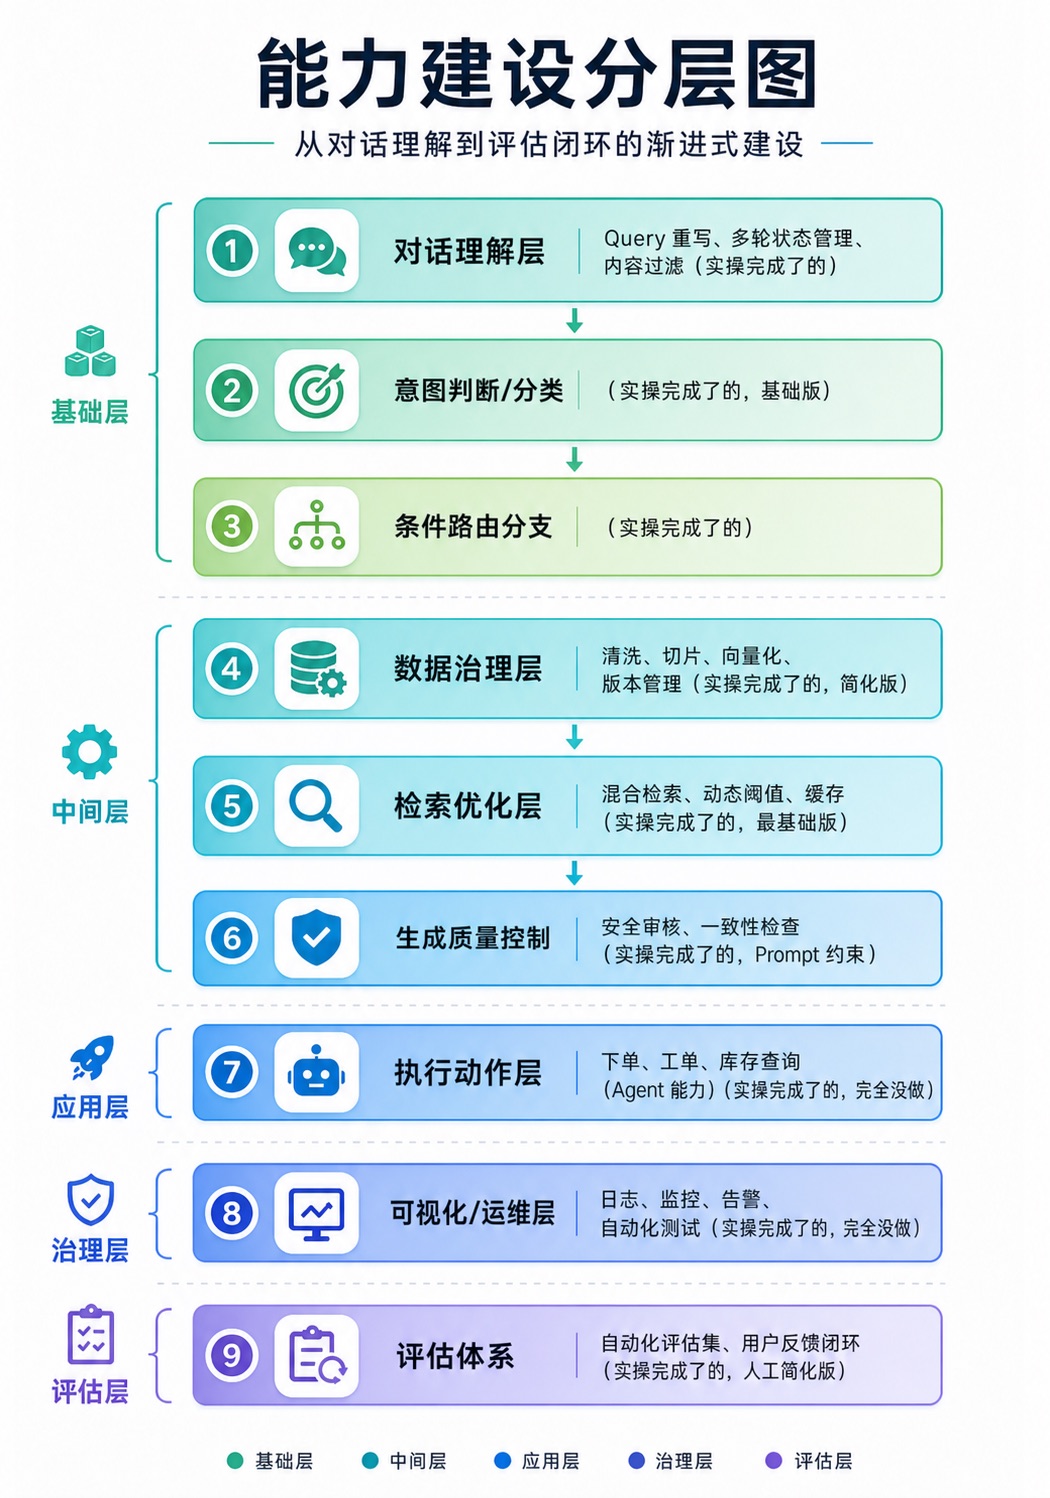
模块一:对话理解层(在"用户输入"之后,"意图判断"之前)
实操没做:

Query重写/改写 —— 补全代词、省略主语(比如"有货吗"补全成"车厘子有货吗")

多轮对话状态管理 —— 记住"用户现在在问第几个商品"这种会话状态

敏感词/违规内容过滤 —— 用户输入里如果有不当内容,提前拦截

多语言识别 —— 如果用户可能用方言、英文提问,需要先识别语言
为什么重要: 你实操中真实遇到的"车厘子凤梨→有货吗→答成草莓"这个案例,根源就是这一层没做完整。这一层没做好,后面所有环节再精细也没用,因为一开始传进去的问题本身就是错的。
模块二:数据治理层(实操做过,但只是最简版)
实操做的:

手动整理Excel,人工划分商品库和知识库


企业级还要做:

数据来源多样化处理 —— 不只是Excel,

还有客服历史聊天记录、产品手册PDF、

甚至语音转文字的录音记录,都要能处理

自动化数据清洗流水线 —— 不是每次人工整理,

是搭一套自动化流程,定期抓取新数据、清洗、更新知识库

数据版本管理 —— 知识库内容变了,

要能追溯"这个版本什么时候改的、改了什么"

敏感数据脱敏 —— 如果知识库里有客户手机号、地址这类信息,

需要脱敏处理,不能直接暴露给LLM
模块三:检索优化层(实操用了最基础版本)
实操用的:

纯向量检索,Top K=3,没开混合检索、没开Score阈值


企业级还要做:

混合检索(向量+关键词+知识图谱三路召回,之前讲过这个概念)

动态Top K —— 根据问题复杂度自动调整检索数量,

不是固定返回3条

Score阈值动态调整 —— 不同类型的问题,

合理的相似度门槛可能不一样

多知识库路由优化 —— 如果企业有几十个知识库

(按部门、按产品线划分),

需要更智能的路由逻辑,不是简单的if/else

缓存机制 —— 高频问题(比如"今天有什么优惠")

直接返回缓存结果,不用每次都重新检索+生成
模块四:生成质量控制层(实操靠Prompt约束,企业级需要更系统化)
实操做的:

在Prompt里手写规则("不要编造""不要用复述句开头")


企业级还要做:

输出内容安全审核 —— 生成的回答,

要过一道"有没有违规内容"的自动审核

一致性检查 —— 同一个问题,多次问答案是否一致,

不能这次说20元下次说25元

敏感操作二次确认 —— 涉及价格承诺、退款金额这类内容,

可能需要人工审核后才能发给用户,不能AI直接说了算

A/B测试框架 —— 同时跑两个版本的Prompt,

对比哪个效果更好,用数据说话,不是靠感觉
模块五:执行动作层(实操完全没做,这是"Agent"的部分)
实操没做:

所有分支最终都只是"生成一段话",没有真正执行任何动作


企业级的Agent能力:

调用真实的下单接口 —— 用户说"我要买",

真的往订单系统写入一条记录

调用真实的库存系统 —— 实时查询当前库存,不是查静态Excel

调用工单系统 —— 生成真实的售后工单,

推送给对应的处理人员

调用物流查询接口 —— 用户问"我的快递到哪了",

真的去查真实物流状态

支付相关接口(需要极高的安全等级,通常有专门团队负责)
模块六:多轮对话与会话管理(实操几乎没做)
实操做的:

简单开了个别节点的"记忆"开关,但不完整


企业级还要做:

会话隔离 —— 微信群里多人同时说话,

要能区分"这句话是谁说的"(你案例里聊过的真实难题)

会话超时管理 —— 用户5分钟没说话,

要不要把这次对话标记为"结束"

上下文长度控制 —— 聊了几十轮之后,

历史记录太长,要做摘要压缩(之前讲过的上下文管理)

跨会话记忆 —— 用户今天问过的问题,

下次再来,系统是否应该还记得
模块七:可观测性与运维层(实操完全没有,企业级必须有)
实操做的:

靠人工肉眼看Dify的"预览"调试面板


企业级还要做:

全链路日志记录 —— 每一次对话,

每个节点的输入输出都要记录下来,方便排查问题

监控告警 —— 如果检索失败率突然升高

系统要能自动报警,而不是靠人工发现

性能监控 —— 响应时间、Token消耗、

成本这些指标要能实时看到趋势

自动化测试 —— 不是每次靠人工测10道题,

是有一套自动化脚本,每次改动Prompt后自动跑几百道回归测试

灰度发布 —— 新版本先给1%的用户用,

确认没问题再全量上线,不是一改完就全部生效
模块八:评估体系(实操做了简化版)
实操做的:

人工10道题+三层打分法


企业级还要做:

自动化评估集 —— 几百到几千条标准问答对,

每次改动后自动跑一遍,不用人工一条条测

用户反馈闭环 —— 真实用户对回答点赞/点踩,

这些反馈要能回流到优化流程里

定期人工抽检 —— 哪怕有自动化评估,

依然需要定期人工抽查真实对话,

因为自动化评估也有局限

效果指标体系 —— 不只是"答得对不对",

还要看转化率、用户满意度、

重复咨询率这些业务指标
三、给你一个直观的完整架构图
四、给你一个务实的判断——这些"没做的",是不是都必须补
不是。企业级系统的完整度,取决于业务规模和风险承受度,不是所有项目都需要做全。
你的教学项目定位:

让学生理解RAG+Agent核心原理,做出可演示、可讲述的作品

→ 实操的"主干"已经足够,

不需要、也不应该在几周教学里塞入所有企业级模块


如果未来你真的要给企业做正式部署:

需要根据具体场景,评估"哪些模块是必须的"

→ 比如给一个只是做内部FAQ问答的企业,

模块五(执行动作层)可能完全不需要

→ 但如果是做真实的电商下单助手,

模块五、模块七(监控)几乎是必须的
五、给课程设计的建议——怎么把这份全貌用起来
核心课时(实操在做的):

只讲主干——意图判断、检索、生成、回复,

让学生能做出完整闭环的项目


选学延伸(学有余力可以讲):

Query重写(实操已经证明了它的必要性,

用的"车厘子凤梨"真实案例讲,非常有说服力)

Score阈值/混合检索(用"菌菇答成鲈鱼"案例讲)

简单的Agent能力(用HTTP请求节点调用一个免费天气API体验)


课程结尾的"认知拓展"(不要求学生做,但要让学生知道):

用这份"全貌图",让学生知道

"你实操做的是核心骨架,企业级系统还有七八个模块要往上加",

这样学生对"AI应用开发"这件事的认知会更完整,

面试时被问到"生产环境和你做的demo有什么区别",

也能答得上来
*本文档基于实操实际搭建过程中发现的真实需求整理,用于个人认知梳理及课程内容规划